0.61
跨文件分析 F1
0.28 → 0.61496
真实 Agent Trace
Observation Kernel~90×
单文件增量图更新加速
10.78s → 0.12s53.8%
困难用例通过率
+7.6pp我的角色与贡献
我在 3 人团队中负责工具治理与优化:分析 496 条真实 Agent 轨迹中的 793 次 schema 校验失败,设计工具契约、证据槽与 AST 提示,并搭建轨迹采集与回放系统。
背景
RepoMind 是腾讯 × 深圳技术大学校企合作项目下的多语言代码知识库与 MCP 工具系统。
挑战
Agent 频繁绕过 MCP 工具直接读文件;即使定位到候选代码,也常缺少解释其相关性的证据。
我们把失败收敛为三个根因:仓库理解不足、上下文检索薄弱、缺乏可观测性。
方案
我制定了三阶段治理路线图,把检索路径从「直接搜索」重构为「候选召回 → 深读 → 关系扩展 → 证据校验」。
01
候选召回
用别名归一化与候选台账,替代大范围 schema 重写,先止血再优化。
02
深读与关系扩展
游标分页 + 证据槽,把「定位到代码」升级为「说清它为什么相关」。
03
证据校验
网关、覆盖率检查与策略层共同守护关键路径,POL/DUP 信号清零。
系统链路
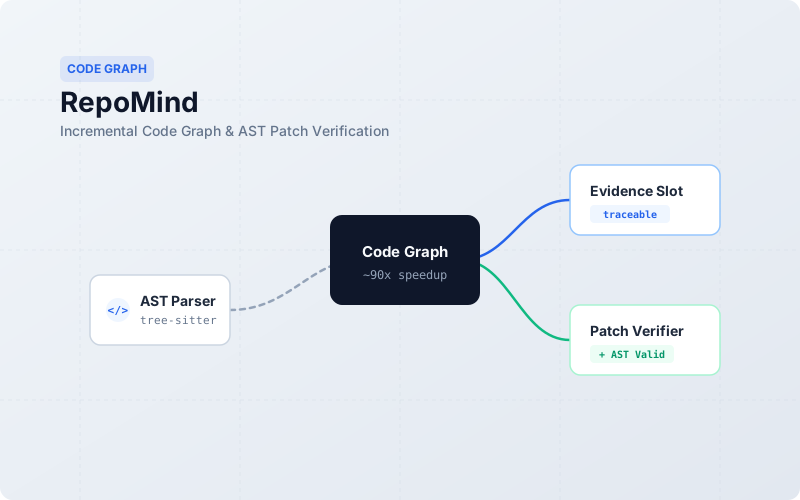
Tree-sitter 解析仓库并增量更新代码图;检索引擎向 Agent 的 MCP 工具提供候选代码,轨迹系统记录调用过程以支持诊断与回放。
技术细节
增量代码图
- 基于 Tree-sitter 解析,通过 Merkle 快照与新鲜度门控治理陈旧索引。
- 单文件更新耗时从 10.78s 降至 0.12s(约 90 倍)。
Agent 可观测性
- 跨工具调用的轨迹采集。
- 工具调用分析以定位失效模式。
- 回归验证用的回放系统。
自适应检索
关键决策
为什么用轻量别名归一化,而不是大范围重写 schema?因为它成本低、可回滚、能先止血,把资源留给更关键的证据链路。
- 用轻量别名归一化替代大范围 schema 重写。
- 候选台账 + 游标分页 + 证据槽。
- AST 提示与 RRF 提供更好的上下文接地。
成果
困难用例通过率
46.2%53.8%
D15 阻断召回
0.0830.250
通过率统计基于 13 个高难并发用例。
- POL/DUP 信号清零;约 6100 行治理、证据与 AST 层代码。
项目价值
轨迹回放与证据校验让工具治理的效果可以复现和衡量。
经验教训
工具治理无法替代推理层,也无法拦截所有外部 harness 调用(Read、Grep、Bash)。下一阶段需要在治理与推理之间划出更清晰的边界——并在扩大范围前准备更好的基线样本。